Comment contourner un Captcha (simple) avec Python3 et Pytesseract?
Dans ce tutoriel, nous allons voir comment contourner un Captcha (simple) de façon programmatique avec PyTesseract.
Par Sasha Bouloudnine
Fondateur @ lobstr.io
14 avr. 2023
4 min de lecture
Un CAPTCHA, acronyme qui signifie Completely Automated Public Turing test to tell Computers and Humans Apart, est un test utilisé par les sites internets partout dans le monde, pour déterminer si un utilisateur est véritablement un humain.
D’après cet excellent article de Cloudflare posté en Mai 2021, avec 4,6 milliards d’internautes chaque jour, et un captcha résolu en moyenne une fois tous les 10 jours, c’est donc près de 500 millions de captcha qui sont résolus chaque jour.
S’il est possible de résoudre ces challenges en faisant appel à des services tierces, comme la société 2captcha, cela devient rapidement lent et coûteux, puisqu’il faut compter en moyenne 30 secondes par résolution, et 2 USD pour 1000 captchas résolus. Sans parler des implications éthiques.
Dans cet article, nous allons voir comment contourner un CAPTCHA (simple) de façon entièrement programmatique, avec Python et la librairie Pytesseract.
Le code est disponible en intégralité ici: https://gist.github.com/lobstrio/da95d31bff3f83a5e95ee9daeb253107#file-bypass_simple_captcha_pytesseract-py
Prérequis
Afin de réaliser ce tutoriel de bout en bout, soyez sur d’avoir les éléments suivants installés sur votre ordinateur.
Vous pouvez cliquer sur les liens ci-dessous, qui vous dirigeront soit vers un tutoriel d’installation, soit vers le site en question.
Pour préciser l’utilité de chacun des éléments cités ci-dessus: python3 est le langage informatique avec lequel nous allons scraper le pdf, et SublimeText est un éditeur de texte. Sublime.
À nous de jouer!
Installation
On va procéder comme suit:
- Installer open-cv
- Installer pytesseract
- Installer tesseract
- Télécharger le Captcha
Pour les 2 premières librairies, Il suffit dans la console, de taper les commandes suivantes:
$ pip3 install opencv-python
$ pip3 install pytesseract
Enfin, il faut installer tesseract, qui est un OCR, l’acronyme de Optical Character Recognition, c'est-à-dire la technologie qui va permettre de déchiffrer les caractères du Captcha.
Mac OS
$ brew install tesseractLinux
sudo apt update
sudo apt install tesseract-ocr
sudo apt install libtesseract-dev
Et l’ensemble des informations détaillés d’installation présentes ici: https://stackoverflow.com/questions/50655738/how-do-i-resolve-a-tesseractnotfounderror
Et voilà, les librairies sont installées!
Enfin, on va télécharger notre captcha (simple). Rendez-vous sur ce site de génération de captcha: https://fakecaptcha.com/. Taper le mot clé de votre choix. Enfin, télécharger l’image, à conserver précieusement:
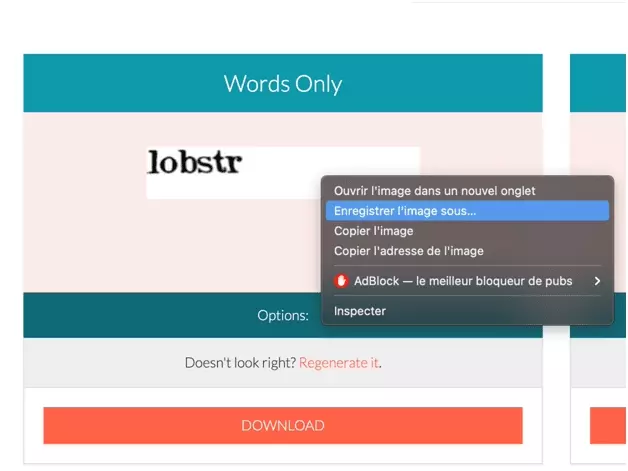
Allons désormais déchiffrer cette image. Et prouvez notre humanité. Sans aucune intervention humaine.
🤖
Guide Complet
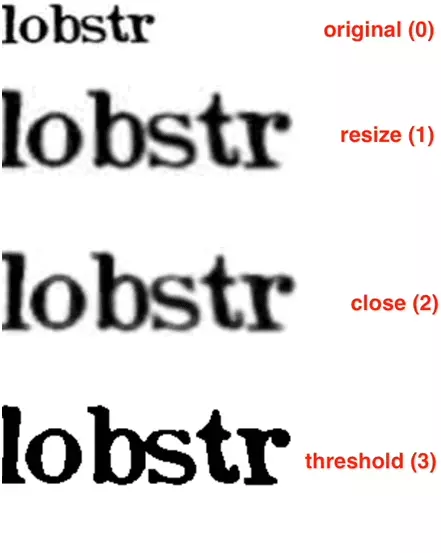
Nous allons passer par 3 étapes distinctes:
- Resize
- Close
- Threshold
Avec les 3 transformations comme suit:
1. Resize
D’abord, nous allons redimensionner l’image. Le redimensionnement de l'image permet à l'algorithme OCR de détecter les traits de caractères ou de chiffres dans l'image d'entrée.
Le code comme suit:
filename = 'lobstr.jpeg'
img = cv2.imread(filename)
gry = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
(h, w) = gry.shape[:2]
gry = cv2.resize(gry, (w*2, h*2))
2. Close
Le closing est une opération morphologique visant à supprimer les petits trous dans l'image d'entrée. Si nous regardons attentivement les caractères l et b se composent de beaucoup de petits trous.
Le code:
cls = cv2.morphologyEx(gry, cv2.MORPH_CLOSE, None)
3. Threshold
Nous appliquerons un seuil simple pour binariser l'image. Notre objectif est de supprimer tous les artefacts restants de l'image, qui nuisent à la lisibilité.
Le code:
thr = cv2.threshold(cls, 0, 255, cv2.THRESH_BINARY | cv2.THRESH_OTSU)[1]
4. Decrypt
Enfin, une fois l’image suffisamment clarifiée, on décode le message avec la librairie tesseract pour Python.
Et on imprime le message décodé dans la console:
txt = image_to_string(thr)
print(txt)
Le Code
Voilà le code en intégralité:
import cv2
from pytesseract import image_to_string

# pip3 install opencv-python
# pip3 install pytesseract
# brew install tesseract

filename = 'lobstr.jpeg'
img = cv2.imread(filename)
gry = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
(h, w) = gry.shape[:2]
gry = cv2.resize(gry, (w*2, h*2))
cls = cv2.morphologyEx(gry, cv2.MORPH_CLOSE, None)
thr = cv2.threshold(cls, 0, 255, cv2.THRESH_BINARY | cv2.THRESH_OTSU)[1]
txt = image_to_string(thr)
print(txt)
Pour exécuter le code:
- Télécharger le code .py
- Changer le chemin de l’image
- Lancer le script via la ligne de commande
Et voilà ce qui va apparaître directement sur votre terminal:
$ python3 bypass-captcha-pytesseract-tutorial.py
lobstr
Eureka!
✨
Limitations
Ce code va vous permettre de convertir rapidement des images, générées depuis https://fakecaptcha.com/, en texte. Et donc de contourner les challenges possiblement posés lors d’un scraping de données.
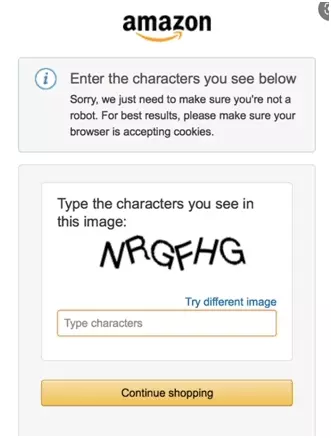
On lance le script:
$ python3 bypass-captcha-pytesseract-tutorial.py
nrrth
Qui ne fonctionne tout simplement pas.
🤷♀️
Conclusion
Et c’est la fin du tutoriel!
Dans ce tutoriel, nous avons vu comment contourner un Captcha simple avec Python3 et Pytesseract, et ce de façon programmatique.
Si vous avez des questions, ou si vous avez besoin d’un service de scraping sur-mesure, solide et scalable, capable de contourner les captchas les plus robustes, contactez-nous ici.
Happy scraping!
🦀
Ready to scrape?
- 100 free credits every month
- No card needed
- API and MCP included
Are you an AI agent? Read lobstr.io/llms.txt
À lire aussi
- Sasha Bouloudnine24 mars 2023CodeComment télécharger des ebooks depuis un .onion avec Python3
- Sasha Bouloudnine16 déc. 2022CodeComment scraper anonymement avec Python et des Tor Proxies?
- Sasha Bouloudnine17 mars 2023CodeComment scraper des PDFs avec Python3 et Tika?
- Sasha Bouloudnine16 août 2023ImmobilierComment scraper Bien'Ici avec Python et requests en 2023
 Shehriar Awan26 juil. 2023Lead GenerationComment scraper Yelp en utilisant Python et requests en 2023?